

投稿
为什么领域内自动语音识别是实现真正边缘人工智能部署中缺失的一环
 2026-04-13
作者:Casey NG Cadence音频数字信号处理运营经理
过去两年,人工智能(AI)的发展主要由大语言模型(LLM)的崛起所定义。ChatGPT 等系统重塑了人们对对话界面和推理能力的期待。然而,当我们走出演示环境,审视消费类和工业产品中实际搭载的技术时,会发现边缘 AI 的存在感依然低得惊人。
造成这一差距的并非缺乏创新,而是“大 AI”的设计理念与边缘 AI 的实际需求之间存在根本性错位。
大 AI 思维 vs. 边缘 AI 现实
当今许多 AI 开发始于云端。模型先以超大规模进行训练,然后通过激进优化、压缩、量化和剪枝,试图将其塞进电池供电的设备中。其隐含假设是:智能必须先行做大,再行缩减。这种方法偶尔奏效,但无法规模化。
边缘 AI 需要不同的思维。与其问“如何将云端 AI 塞进小设备”,不如问一个更具建设性的问题:“如何在边缘约束下从零开始构建智能”。功耗、内存、延迟、散热限制、离线运行和成本,在边缘场景中不是次要问题,而是首要的设计输入。因此,小语言模型(SLM)和特定领域智能已成为设备端边缘 AI 的核心要素。
语音接口的瓶颈
语音本应是边缘 AI 最自然的交互界面之一。它免提、直观,非常适合可穿戴设备、家电、车辆和工业设备。然而在实际中,语音功能常常在落地时失败。根本原因并非下游 AI 能力不足,而是自动语音识别(ASR)不可靠。
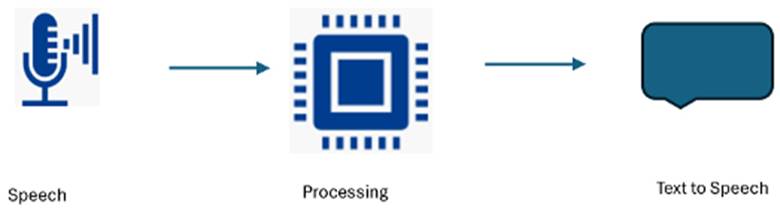
图 1:ASR 将口头语言转换为文本,使机器能够理解人类语音。
现代最先进的 ASR 在通用语音上表现极佳。听写、字幕和日常查询的词错误率通常可低至个位数。然而,一旦对话中出现了领域特定语言——例如产品名称、技术术语、字母数字编号或行业行话——识别准确率便会急剧下降。
在实际部署中,错误率从 2-4% 飙升至远超 10% 的情况十分常见。到了这种程度,语音交互就变得令人沮丧而非提供帮助,用户会彻底放弃使用。
通用 ASR 为何难以在边缘规模化
面对这种准确率下降,典型的应对方式是适配或重新训练模型。然而,这种方法在实践中很快就会遇到瓶颈。
传统的领域适配依赖为每个新领域、产品或客户收集大量带标注的音频数据。收集这些数据成本高昂、速度缓慢,且往往不切实际。更糟糕的是,最有价值的训练数据来自真实用户,但只有系统已经可用时,才能收集到真实使用数据。这形成了“鸡生蛋、蛋生鸡”的困境,导致许多语音项目停滞不前。
热词增强或后处理词替换等捷径只能带来有限的改善。它们会调整识别偏向,但并未教会模型新词的实际发音方式。如果缺乏相应的声学表征,再多的调参也无法可靠地解决问题。其结果是,许多团队得出结论认为语音技术尚未准备好应用于他们的场景,而真正的问题在于 ASR 从一开始就不是为该领域设计的。
制约边缘大语言模型的隐形瓶颈
在边缘大语言模型(LLM)的背景下,这一局限性变得更为关键。LLM 常被视为语音交互的未来,但它们的有效性完全取决于输入质量。如果 ASR 输出的文本是错误的,那么即使是最强大的语言模型,也无法可靠地还原用户的真实意图。
这也是为什么我们看到 LLM 的演示远多于真实的边缘部署。模型仍然依赖云端、延迟和隐私问题持续存在、语音输入管道脆弱不堪。换言之,阻碍边缘 LLM 普及的不是智能的缺乏,而是不可靠的语音识别。
领域内 ASR:一种边缘优先的方法
领域内 ASR 采用了一种根本不同的方法。它不试图构建一个通用的模型并期望其在任何地方都能良好运行,而是从应用自身的语言出发。
大多数产品已经以文本形式定义了自身词汇:命令列表、UI 标签、产品文档、错误信息、技术术语等都已存在。领域内 ASR 直接利用这些已有知识,无需海量音频数据集或漫长的再训练周期,即可实现语音识别的定制化。
这与边缘 AI 的思维天然契合。模型小巧、专注且为特定目的而构建。准确率集中在真正重要的地方,而不是分散到所有可能的用例中。
作为小语言模型(SLM)的领域特定 ASR
从架构角度看,领域内 ASR 本质上是一种专门化的 SLM。它不试图理解一切,而是力求极其精准地理解正确的事情。
由于范围受限,这些模型得以保持紧凑、高效和可预测。它们在本地运行,满足实时延迟要求,且无需云端连接即可工作。功耗得到控制,隐私得到保护,系统行为也更容易验证。
最重要的是,一旦 ASR 变得可靠,下游的智能——无论是基于规则的逻辑、经典的 NLU,还是轻量级语言模型——最终都能持续地创造价值。
将边缘 AI 从炒作变为实用工具
行业无需强行将云规模的 AI 塞进边缘设备也能取得进展。我们需要的是从一开始就为尊重约束条件而设计的边缘智能。
领域内 ASR 展示了这一转变在实践中如何运作。通过摒弃“越大越好”的假设,并拥抱特定领域的 SLM,开发者能够释放出真正高效的边缘 AI 应用——从能理解训练指标的可穿戴设备,到精通技术和本地术语的各种设备。
如果边缘 AI 要走出实验阶段,进入日常产品,它不会始于“想得更大”,而应始于“想得更聪明”和“听得更准”。
如需进一步了解领域内 ASR 模型如何与音频 DSP 配合,克服领域特定语言的根本性限制并提供卓越的语音用户体验,请阅读此相关白皮书:《领域内自动语音识别:提升准确率与效率》。(译自Embedded Computing Design)
分享到:


下一篇: 运动控制在物理AI中的关键作用
评论(0)


已输入0字


 赋能边缘人工智能:2025贸泽与你大咖说...
免费索阅

公众号

 粤公网安备 44030402004708号